MMBench
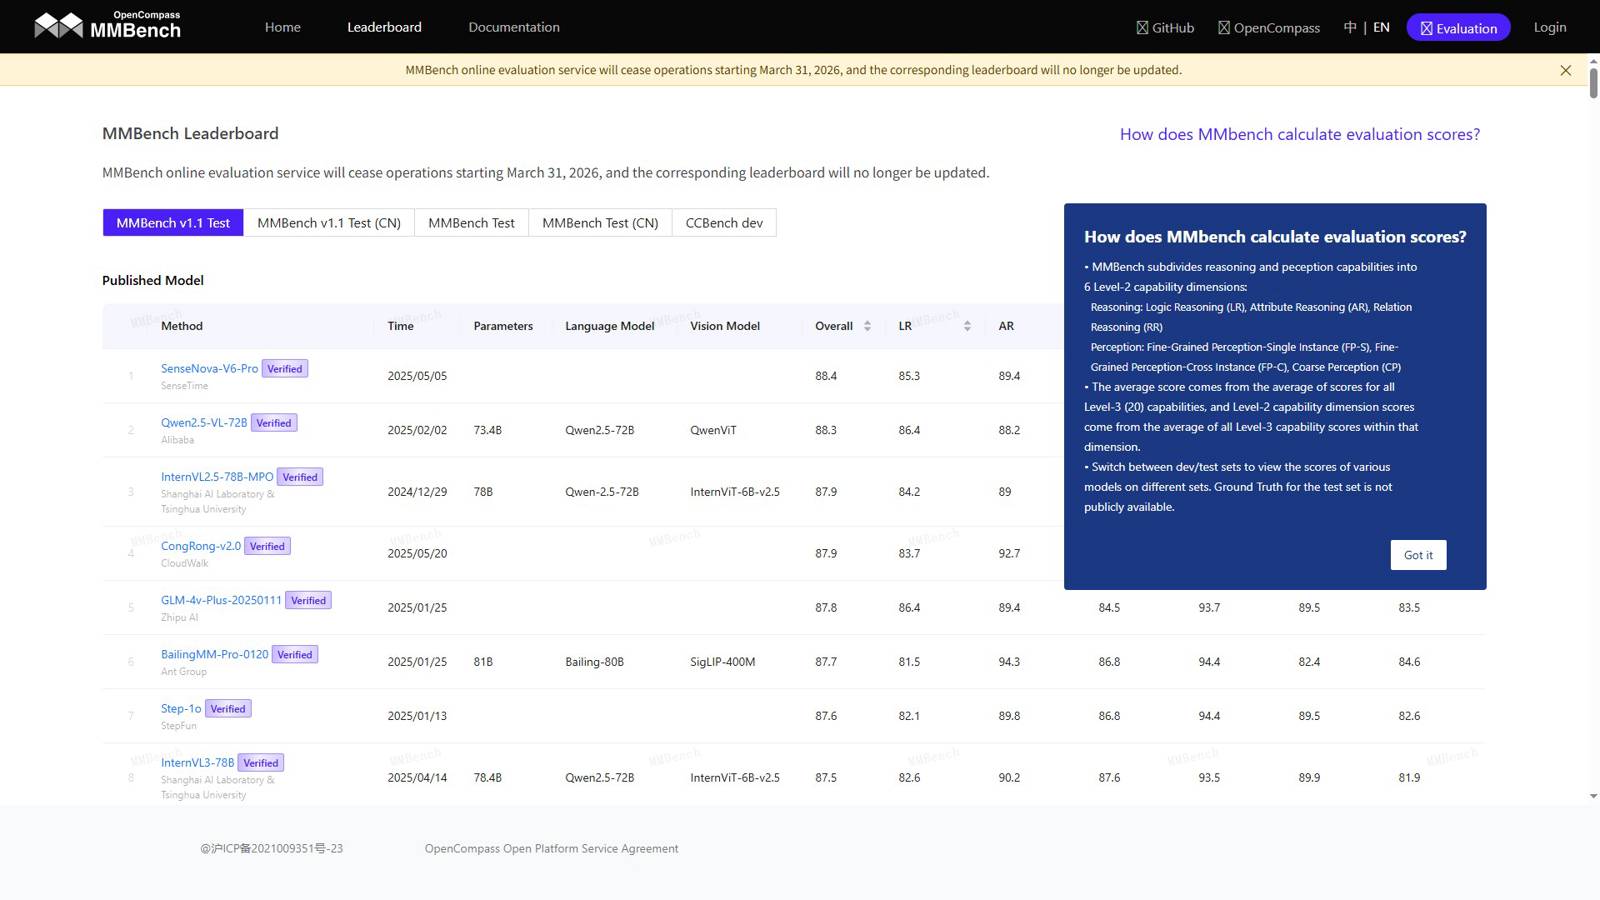
MMBench是OpenCompass推出的多模态大模型评测基准,标准化测试模型的图文理解能力,覆盖感知、认知、推理等能力维度,并发布公开排行榜。
MMBench是OpenCompass体系下的多模态大模型评测基准,主要测试模型对图像和文本的理解能力(VLM,视觉语言模型)。随着GPT-4V、Gemini等视觉大模型的出现,如何公平评测它们的图文理解能力成了重要问题,MMBench就是为了解决这个问题而设计的。
它把多模态能力拆成感知、认知、推理等维度,用标准化任务测试模型看到图片能不能正确理解、并基于图文信息进行推理。
核心功能
图文理解评测:标准化测试多模态大模型对图像和文本的理解能力。
能力维度划分:覆盖感知、认知、推理等多模态能力维度。
公开排行榜:发布主流多模态模型的排名。
持续更新:随多模态模型发展持续更新评测集。
使用教程
- 访问mmbench.opencompass.org.cn查看排行榜。
- 了解各多模态模型的排名和分维度表现。
- 对比不同视觉语言模型的能力差异。
优点
- 专注多模态(图文)理解,评测聚焦。
- 维度划分清晰(感知、认知、推理)。
- 公开排行榜,对比直观。
- 依托OpenCompass生态。
需要注意的地方
- 主要测图文理解,对视频、音频等多模态能力覆盖有限。
- 榜单随模型版本迭代变化。
适合谁用
关注视觉语言大模型(VLM)能力的开发者、研究者、AI产品经理,以及需要选型多模态模型的团队。
定价
MMBench评测结果和排行榜公开,免费查看。
同类型产品对比
| 产品 | 价格/模式 | 核心特点 | 适合人群 |
|---|---|---|---|
| MMBench | 免费 | 图文理解、多模态评测 | 多模态模型选型 |
| OpenCompass | 开源 | 全面评测框架(含MMBench) | 研究者、开发团队 |
| MMLU | 开源基准 | 多任务语言理解 | 通用模型评测 |
常见问题
MMBench是什么
MMBench是OpenCompass推出的多模态大模型评测基准,标准化测试模型的图文理解能力。
MMBench评测哪些维度
覆盖感知、认知、推理等多模态能力维度。
MMBench和OpenCompass什么关系
MMBench是OpenCompass评测体系中的一个多模态评测基准,OpenCompass是更全面的评测框架。
MMBench的排行榜怎么看
在mmbench.opencompass.org.cn可查看主流多模态模型的排名和分维度表现。
引用来源
- MMBench官网:https://mmbench.opencompass.org.cn/leaderboard
- MMBench介绍:https://kcool.cn/mmbench